
同样问 AI,一个人得到的是几条熟悉的概念,另一个人却能继续讨论背景、证据、反例和下一步验证。差别看起来像模型能力,很多时候先要检查的其实是问题有没有说清楚:AI 不知道提问者手里的材料、真实目标和判断标准,就只能用常见答案补空白。
把问题聊深,不靠一段神秘提示词,也不是把指令写得越长越好。更有效的做法是先给足关键背景,再把复杂任务拆成几轮,让 AI 说明依据、指出不确定处,并接受追问和修正。
一、为什么第一轮回答经常显得浅
“帮我分析一下 AI 行业”“怎么提升产品增长”看起来是问题,实际更像一个话题。没有对象、场景、材料和目标时,AI 很难知道该从哪一层回答,于是通常会给一份四平八稳、谁看都能用一点的概述。
另一个常见原因,是把整项工作塞进一次提问:既要搜集信息、判断趋势,又要比较方案、给出行动计划。模型会努力压缩内容,最容易被压掉的正是推理所需的背景、证据和限制条件。最后看着面面俱到,真正能拿去做决定的部分却不多。
二、先把问题从“话题”改成“任务”
提问前,先补齐六件事:讨论对象、实际场景、要解决的目标、现有材料、限制条件,以及希望拿到的结果。角色设定可以帮助调整视角,但“你是一位专家”本身不能替代事实和背景。
例如,不只问“怎么提升产品增长”,而是说明产品面向谁、当前卡在哪里、已经观察到什么,再要求 AI 区分事实与推测,提出可以验证的原因。下面这段可以直接改成自己的场景:
> 我在负责【产品/项目】,主要面向【目标用户】。目前遇到的问题是【具体表现】,已知信息包括【数据、用户反馈或已有尝试】。请先指出还缺少哪些关键信息,再提出 3—5 个可能原因。每个原因请分别写出支持它的证据、可能的反例、还需要补充的数据,以及一种低成本验证方法。不要把推测写成事实;最后按优先级给出下一步行动。
这类提问不会保证答案一定正确,但它让 AI 有材料可分析,也让读者能看出结论从哪里来、接下来怎么检验。
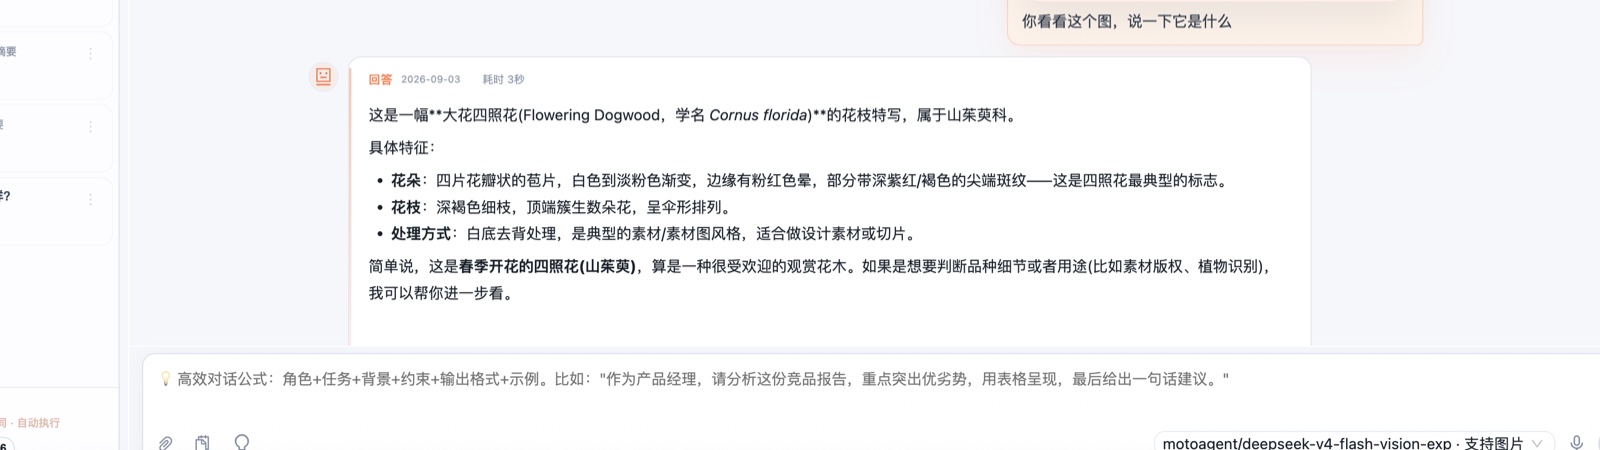
图:MotoAgent 的历史对话界面。底部提示展示了“角色、任务、背景、约束、输出格式、示例”的提问结构;截图中的花卉识别对话仅用于展示界面,并非本文的分析案例。
三、别急着要结论,用追问把分析往下推进
第一轮回答更适合当作草稿,而不是最终结论。可以依次追问:它依赖了哪些假设?哪些信息还缺失?有没有更合理的替代解释?什么证据会推翻当前判断?最后再让它把分析落到一个可以执行、可以检查的动作上。
比如接着输入:
> 请把上面的内容分成“已知事实、推断、建议”。找出最可能被忽略的另一种解释,并说明需要什么证据才能区分。若现有信息不足,请先问我最多 3 个关键问题,不要直接补全事实。
这比一味要求“再深入一点”更有用,因为它明确指出了要深入的方向。复杂任务还可以分成几轮:先梳理问题和缺失信息,再分析原因,再找反例,最后形成验证计划。每一轮只推进一层,答案通常更容易检查和修正。
要求 AI 展示结论依据、关键假设、证据和不确定性即可,不必要求它输出所谓“完整内心推理”。真正有价值的是可核对的理由与结果,而不是一大段无法验证的过程描述。
四、怎样判断讨论真的变深了
一份更有用的回答,通常不只是更长,而是能回答几个具体问题:它有没有结合用户提供的材料?有没有把事实与推测分开?有没有给出其他可能性和反证?建议能不能通过数据、实验或实际操作验证?如果这些问题都没有回应,增加篇幅未必代表分析更深入。
模型和工具能力也会影响结果。需要最新信息时,要提供可用的资料或搜索能力;需要分析文件时,要把文件交给它;不同模型擅长的任务也不完全相同。但换一个更强的模型,不能代替清楚的目标、真实的上下文和必要的复核。
五、把提问方法放进日常工作流
真正用起来之后,麻烦往往不只在怎么写提示词,还在于不同智能体、模型和消息入口分散在不同地方。上下文要反复复制,渠道要来回切换,前一轮讨论的材料也容易遗漏。
MotoAgent 把对话、智能体和已连接的消息渠道集中在一个桌面入口中。使用者可以在界面里切换当前已配置的 Agent;在支持的配置下,也可以把不同账号或渠道接入统一工作流,减少来回打开多个工具的步骤。多 Agent 适合做分工:一个先列假设,另一个专门找反例;但要比较结果,仍应把同一份问题背景和材料分别提供给它们,不能默认不同会话会自动共享上下文。

图:MotoAgent 历史界面中的智能体入口示例。实际可用列表和消息渠道以当前版本及账号配置为准。
它解决的是入口分散和切换成本,不会自动把浅问题变成深分析。使用者仍需要把任务讲清楚,要求依据和边界,并对重要结论做复核。把方法和工具配合起来,才更容易让一次随手提问,变成一轮真正能推进工作的讨论。
MotoAgent 官网:
相关文章:
- Hermes Agent(爱马仕)现在没人用了吗?装好以后怎样接入日常消息
- MotoAgent 多员工多 AI Agent 同时在线 — 每人用不同的 AI,互不干扰
- OpenClaw(龙虾)现在没人用了吗?为什么有人装完就不再打开
- MotoAgent 定时任务:定时执行 + 多渠道结果推送,人人都能用上 AI 自动化
- MotoAgent — 家庭 AI 管家,多人多平台多 Agent 随心切换,人人都能用上 AI
- 国内想体验 OpenClaw、Hermes,Windows 怎么少折腾?一键安装实操
- MotoAgent 开箱即用:OpenClaw + Hermes 双 Agent 桌面工作台,免 Token 配置开机即用
- AI Agent 下载后还要配环境?怎样直接开始第一段对话